12장 · 문서 로딩과 청킹왜 RAG가 필요한가 — 규정은 모델의 머릿속이 아니라 문서에 있다RAG의 두 시점 — 미리 해 두는 일과 질문마다 하는 일PDF에서 텍스트 꺼내기 — 눈에 보이는 대로 나오지 않는다청킹 — 어디서, 얼마나 크게 자를 것인가메타데이터 — 조각에 출처를 적어 둔다따라하기 — 정책 문서 로딩과 청킹정리와 체크리스트실습문제와 해답
12장. 문서 로딩과 청킹
RAG의 두 시점 — 미리 해 두는 일과 질문마다 하는 일
한 줄 요약
RAG는 두 시점으로 나뉩니다. 문서를 조각내 저장해 두는 인덱싱 시점과, 질문이 올 때마다 조각을 찾아 답하는 질의 시점입니다. 이번 장은 인덱싱 시점의 앞 절반인 로딩과 청킹을 합니다.
1. 그림으로 보기
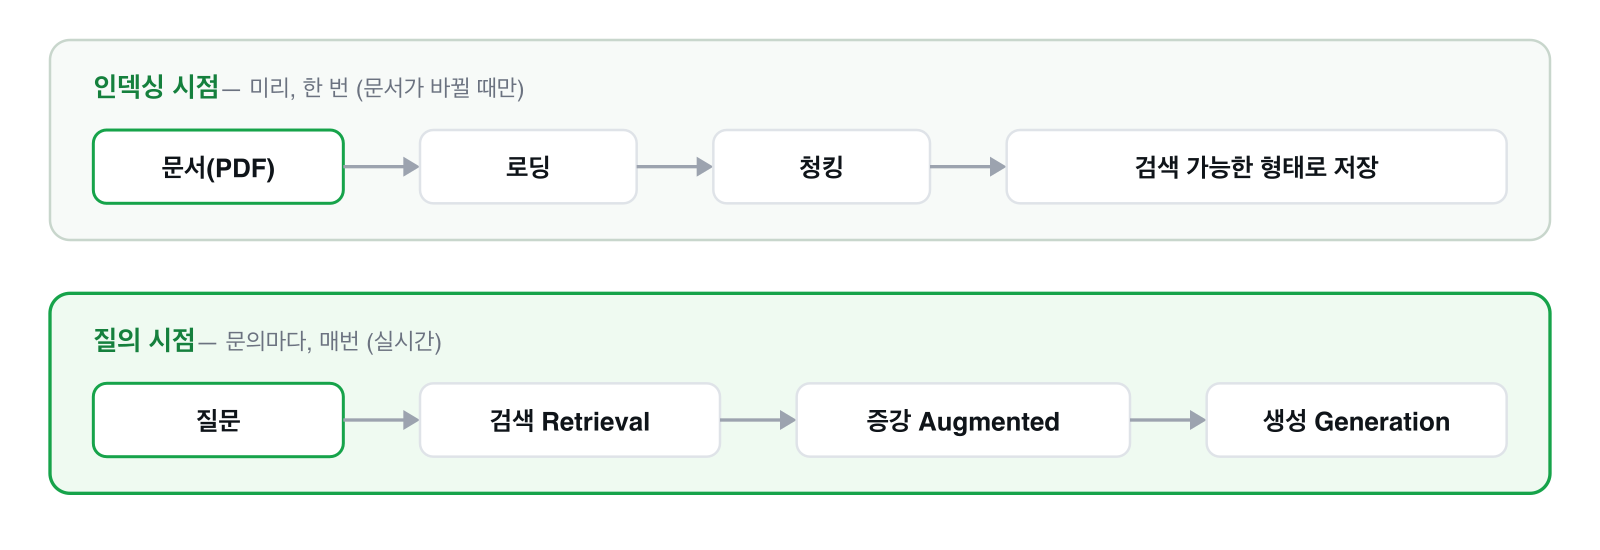
2. 두 시점
| 인덱싱 시점 | 질의 시점 | |
|---|---|---|
| 언제 | 문서가 새로 생기거나 바뀔 때 | 고객이 질문할 때마다 |
| 하는 일 | 문서 읽기 → 조각내기 → 저장하기 | 조각 찾기 → 프롬프트에 붙이기 → 답 쓰기 |
| 얼마나 자주 | 드물게 | 매번 |
| 이 과정에서 | 12장, 13장 | 14장, 15장 |
인덱싱(indexing) 은 나중에 빨리 찾을 수 있도록 미리 정리해 두는 일입니다. 책 뒤의 찾아보기(index)를 만드는 것과 같습니다. 찾아보기는 책을 쓸 때 한 번 만들고, 읽는 사람은 볼 때마다 그것을 씁니다.
시점을 나누는 이유는 어느 단계에 시간과 비용을 쓸지 정하기 위해서입니다. 인덱싱은 드물게 하므로 시간이 좀 걸려도 됩니다. 질의는 고객이 기다리는 동안 일어나므로 가벼워야 합니다. 시간이 많이 드는 일은 인덱싱 단계에서 처리합니다.
3. 인덱싱 시점의 세 걸음
| 걸음 | 뜻 | 이 과정에서 쓰는 것 | 장 |
|---|---|---|---|
| 로딩 (loading) | 파일에서 글을 꺼낸다 | pypdf |
12장 |
| 청킹 (chunking) | 글을 검색 단위의 조각으로 자른다 | RecursiveCharacterTextSplitter |
12장 |
| 저장 | 조각을 뜻으로 검색할 수 있는 형태로 넣어 둔다 | 임베딩 + Chroma | 13장 |
자른 조각 하나를 청크(chunk) 라고 합니다. 검색의 결과는 문서 전체가 아니라 청크입니다. "반품 배송비는 누가 내나요?"라고 물으면 정책 문서 다섯 쪽이 아니라 그 내용이 든 청크 두세 개가 돌아옵니다.
4. 이번 장이 뒤의 전부를 좌우한다
이번 장에는 LLM 호출이 없습니다. PDF를 읽고 글을 자를 뿐입니다. 그런데 RAG의 품질은 여기서 상당 부분 정해집니다.
| 이번 장에서 생긴 문제 | 뒤에서 나타나는 모습 |
|---|---|
| PDF에서 글이 깨져 나왔다 | 검색이 엉뚱한 조각을 찾는다 |
| 표의 제목과 내용이 다른 청크로 갈렸다 | 찾은 조각이 무엇에 대한 표인지 모델이 모른다 |
| 청크에 출처를 적어 두지 않았다 | 답변에 "제2조에 따르면"을 붙일 수 없다 |
뒤의 단계는 앞 단계가 준 것만 가지고 일합니다. 모델이 아무리 좋아도 건네받지 못한 내용으로는 답할 수 없습니다.
5. 도구와 RAG는 함께 쓴다
RAG가 도구를 대신하는 것은 아닙니다. 둘은 맡는 질문이 다릅니다.
| 질문 | 맡는 쪽 | 이유 |
|---|---|---|
| 제 최근 주문 지금 어디까지 왔어요? (Q1) | 도구 | 주문 데이터에서 조회한다 |
| 불량품이 왔는데 반품 배송비를 제가 내야 하나요? (Q3) | RAG | 정책 문서의 문장이 답이다 |
| 단순 변심으로 반품하면 배송비 내야 해요? (Q5) | 둘 다 | 등급은 도구로 확인하고, 규정은 문서에서 찾는다 |
Q5 같은 질문을 풀려면 두 가지를 다 갖춘 뒤 질문에 따라 골라 쓰는 구조가 필요합니다. 그것이 18장 이후의 주제입니다.
핵심 정리
- RAG는 인덱싱 시점(미리, 드물게)과 질의 시점(질문마다)으로 나뉩니다.
- 인덱싱은 로딩 → 청킹 → 저장 세 걸음입니다. 이번 장은 앞의 두 걸음을 합니다.
- 검색의 단위이자 결과는 청크입니다.
- 이번 장에서 생긴 문제는 뒤에서 검색 실패와 근거 없는 답변으로 나타납니다.
- 도구는 표에서 값을, RAG는 글에서 대목을 가져옵니다. 둘을 함께 씁니다.